
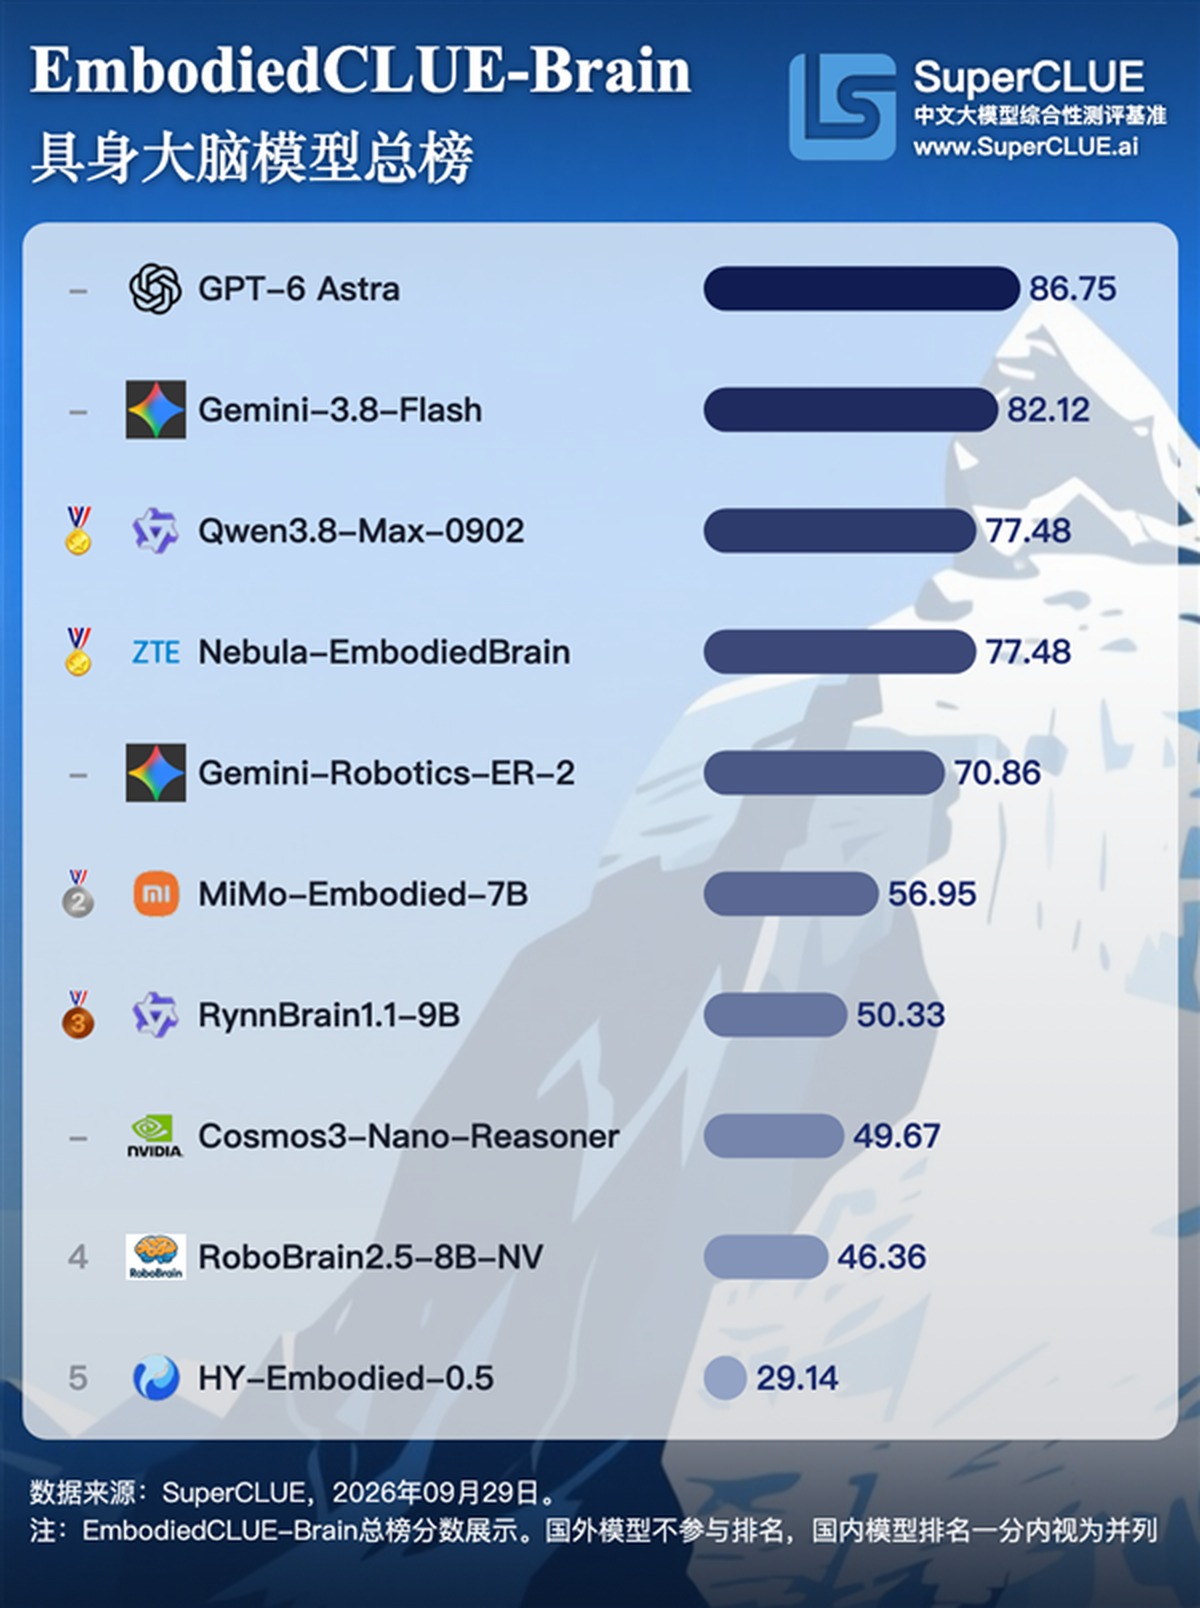
【最新一期具身大脑评测榜单出炉:OpenAI的GPT-6 Astra综合得分领跑全球,而国内第一的位置由阿里达摩院与中兴并列拿下——一张榜单,把”机器人该由谁来思考”这个问题的答案分层摆了出来。】
先搞清楚,”具身大脑”到底难在哪
很多人看到”具身大脑”四个字,第一反应是”不就是给机器人装个大模型吗”。这个理解偏差不小。聊天大模型的任务是生成一段合理的文本,答错了顶多被吐槽;而具身大脑的任务是输出一个动作序列,然后由真实硬件去执行——抓取、移动、避障、应对突发的环境变化。动作一旦错了,代价是摔杯子、撞墙、甚至伤到人。
这就决定了具身大脑必须同时具备三件事:看懂画面、听懂语言、会规划动作,而且三者得打通。视觉给出的是”眼前有什么”,语言给出的是”我想干什么”,中间那段把意图翻译成步骤的推理链条,才是真正拉开差距的地方。评测榜单之所以把长逻辑推理、复杂任务拆解放在权重很高的位置,正是因为它对应着机器人能不能干”多步骤的活”。
全球第一与国内并列第一,是两条不同的路
GPT-6 Astra这次综合得分遥遥领先,优势集中在长逻辑推理与复杂任务拆解上。说白了,它的强项是”想得远、拆得细”——面对一个需要七八个环节串起来的任务,它能保持前后步骤不跑偏。这个能力背后是通用推理底座在撑,属于典型的”大脑强、身体弱”路线。
国内这边,阿里达摩院与中兴同分并列第一,但两家的技术指纹完全不同。阿里的版本主打时空记忆,通俗讲就是”被打断了还记得自己原本要干嘛”,机器人中途被叫去干别的,回头还能接上原先没做完的动作序列;中兴的版本则偏向端侧落地,重点在硬件适配与实时性,更适合直接跑在实体机器人身上,对算力和功耗也更友好。
这两条路没有绝对的优劣,反而更像是同一枚硬币的两面:记忆与规划决定上限,端侧效率决定能不能真正量产装箱。谁先在这两者之间找到平衡点,谁就更可能拿到下一阶段的主动权。
差距得承认,但窗口期还没关上
榜单也没留情面。国内头部模型与GPT之间,总分仍有一段可见的距离。短板集中在两处:一是遇到步骤繁多的连锁任务时偶尔会判断出错,二是在陌生环境中的泛化能力还不足——训练时见过的场景能做,稍微换个光照、换个桌面布局就容易犯懵。
不过这个差距不必被过度放大。人形机器人整体还处在早期阶段,行业甚至还没形成统一的评测标准,眼下的分数更多反映的是”当前技术形态下的相对位置”,而不是终局。更重要的是,具身大脑的能力边界会直接决定未来机器人到底能承担多少实际工作——是只能搬箱子,还是能进厨房、进仓库、进养老院。
从迭代节奏看,各家投入都还在加码,模型版本以季度为单位刷新。在这个阶段,领先半个身位并不构成护城河,真正决定胜负的是数据闭环的能力:谁能把机器人在真实环境里跑出来的失败案例最快地喂回训练,谁就能更快补齐泛化这块短板。差距大概率会缩小,但缩小的速度取决于谁能先把”真实世界的数据”变成自己的资产。
— END —
萌头条编辑部原创发布 · 转载请注明出处


